Descritivo do Projeto
Mesa dos 28
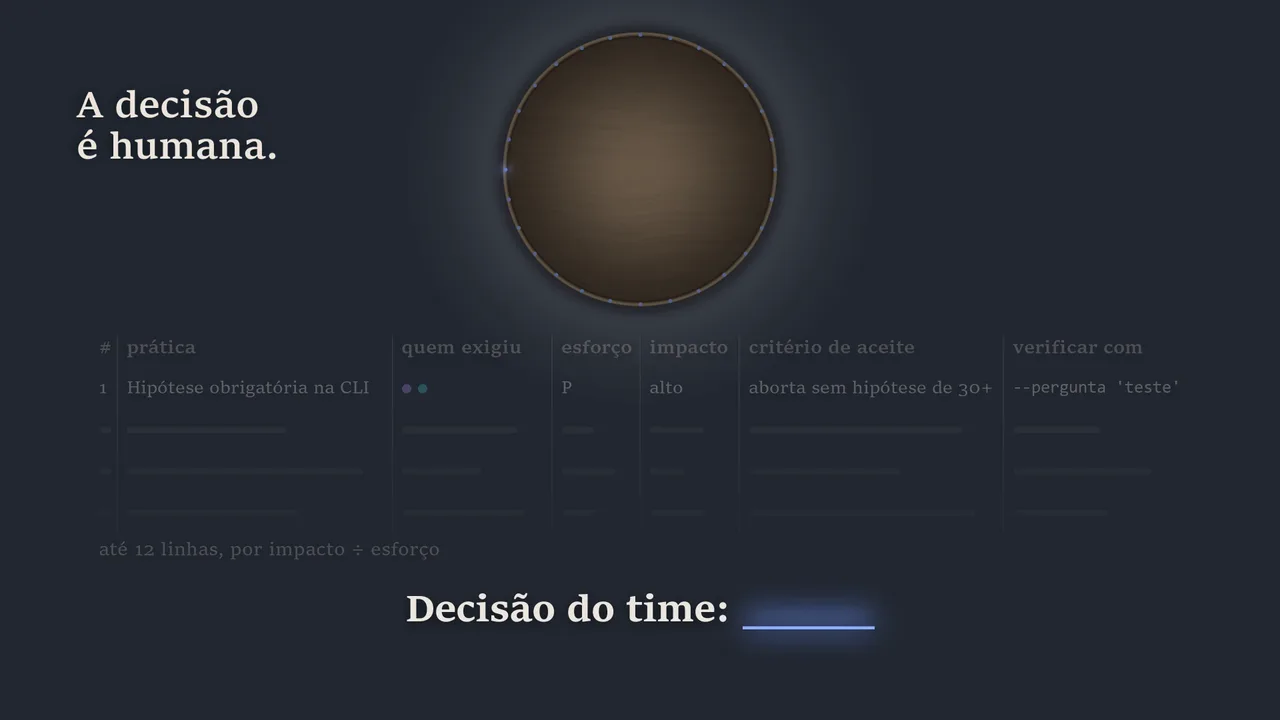
Quem revisa o que a IA escreveu? Lentes baseadas no trabalho público de 28 especialistas leem o projeto e citam arquivo e linha; o código confere cada citação, e a decisão final é humana.
- Papel
- Autor, projeto pessoal
- Período
- 2026
- Situação
- em andamento
- LLMs e agentes
- Python
- Claude Code
- Codex
- Antigravity
- pytest
- mypy
- ruff
Evidências
108 de 108 citações conferidas no disco
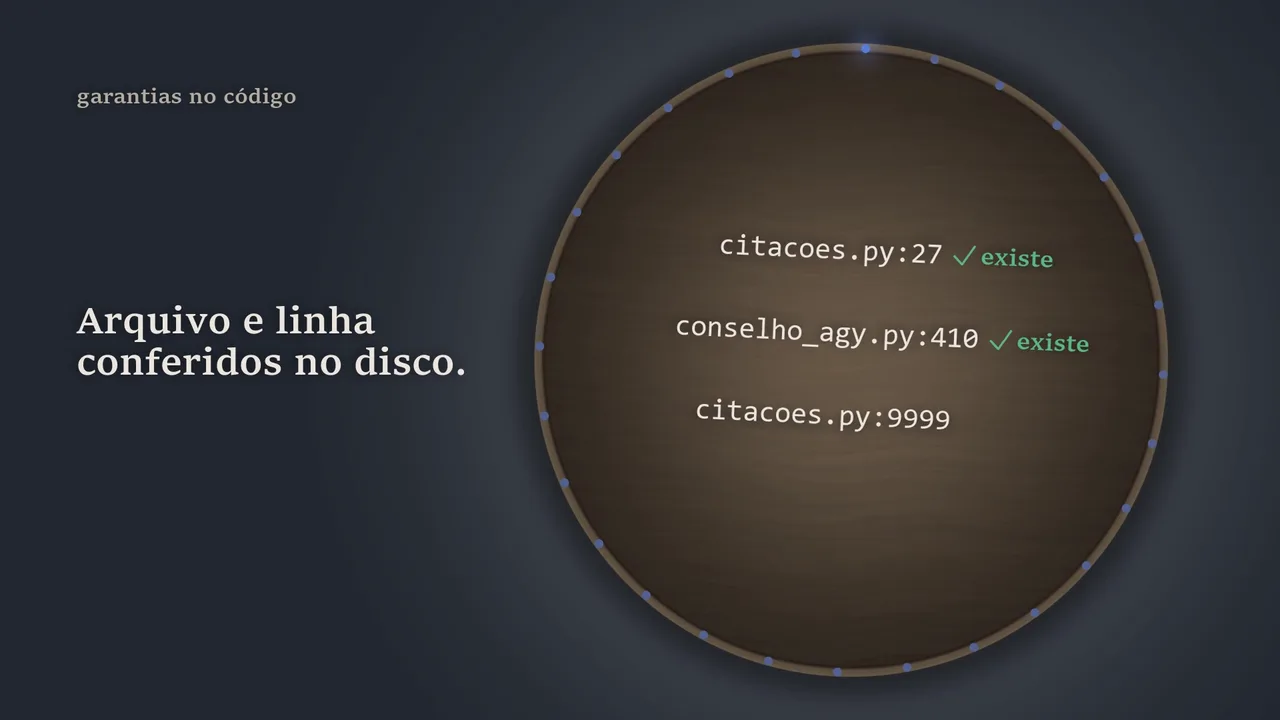
Na rodada de 18/09/2026 em que cinco lentes revisaram a própria mesa: cada citação arquivo:linha é checada contra o arquivo, e 3 foram corrigidas na segunda chance. A checagem prova que a linha existe, não que ela sustenta a afirmação.
Medido.
58 funções de teste, com teste de mutação
Contadas no recorte público do código em 30/10/2026; pytest com ruff e mypy. O teste de mutação planta um defeito por vez e confere se a suíte o pega.
Medido.
Tema da pergunta com 85% de acerto (ECE 0,08)
laya-tema, avaliado uma única vez num conjunto final trancado de 108 perguntas; na mesma prova, a regra de palavra-chave acertou 50%.
Medido. Ver detalhes
Eficácia por rodada, com defeitos reais, falsos alarmes e custo
Protocolo pré-registrado com 10 defeitos semeados e 3 iscas; as rodadas aguardam aprovação.
A medir.
O problema
Código escrito com IA chega rápido, mas sem rastro: decisões sem justificativa, testes que não rodaram e “fatos” que ninguém conferiu. Revisar tudo à mão não escala, e acompanhar o que dezenas de especialistas publicam toda semana custa horas.
A Mesa dos 28 é um segundo par de olhos sistemático para quem constrói com IA: lentes que citam o que leram, um backlog com critério de aceite, e a decisão com a pessoa.
As garantias no código
Cada lente é um subagente gerado por código a partir de um guia com citação, link e data. O que pode dar errado fica preso no código, não no prompt:
- citações
arquivo:linhaconferidas contra o disco, com uma correção e depois expurgo; - orçamento de tokens, com recusa acima do teto;
- conteúdo do projeto revisado tratado como dado, contra injeção de prompt indireta;
- máscara de segredos, com uma asserção no fim;
- teste de mutação sobre os próprios testes.
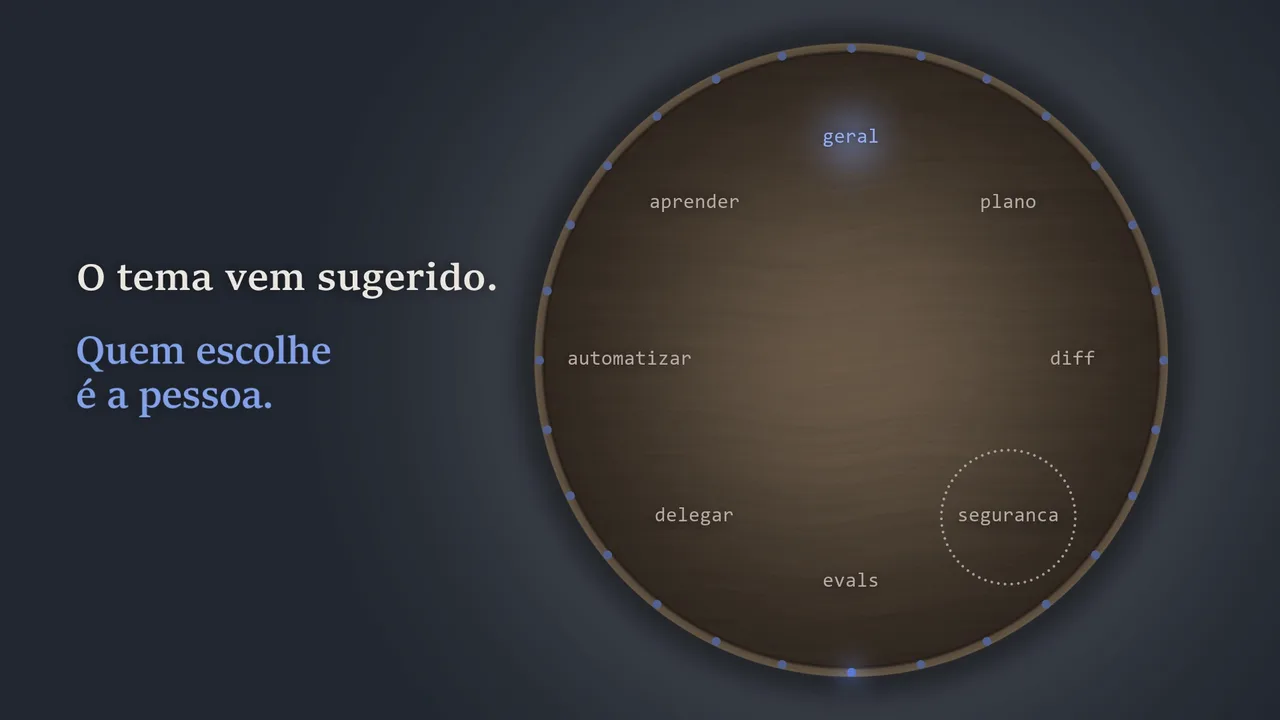
Os guias são atualizados toda sexta-feira por uma tarefa agendada que busca as fontes publicadas de cada especialista. O tema de cada pergunta é sugerido pelo laya-tema.
Na tela
Toque fora da imagem para fechar.
Toque fora da imagem para fechar.
Toque fora da imagem para fechar.
Toque fora da imagem para fechar.
Toque fora da imagem para fechar.
Como funciona
Seis etapas, da pergunta ao backlog. O modelo lê e escreve; o código confere.
- Aposta
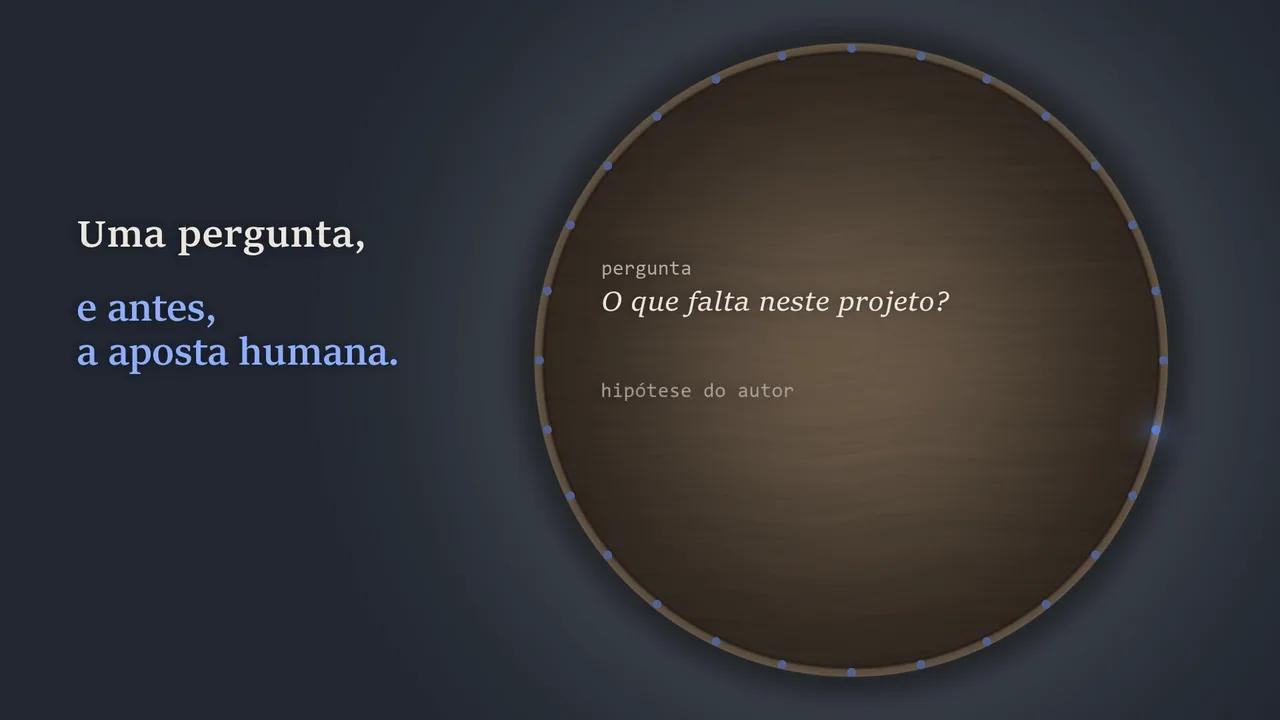
A pessoa escreve a hipótese antes; pular é possível, mas fica registrado.
Python - Tema
O laya-tema sugere um dos 9 temas; sozinho, só vale com confiança de 0,8 ou mais.
laya-tema85% de acerto - Contexto
Monta o contexto, roda os testes do projeto, mascara segredos e estima o custo.
Pythonteto de 2 M tokens - Lentes
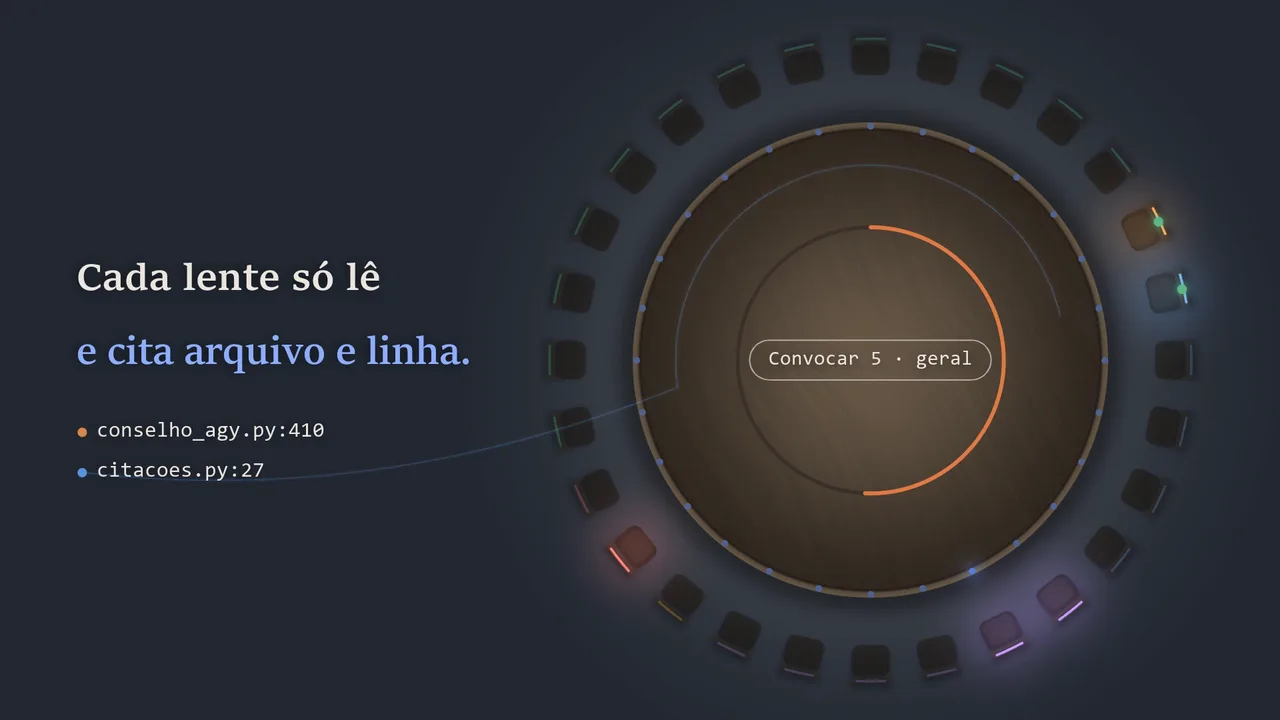
De 3 a 5 subagentes, só com leitura, escrevem pareceres que citam arquivo e linha.
Antigravity CLI - Citações
O código confere cada citação no disco; a que falha ganha uma correção e depois sai.
Python108 de 108 - Backlog
O moderador junta tudo em até 12 itens, cada um com critério de aceite.
Python
O consolidado sai em Markdown, com um cabeçalho de verificação escrito pelo código, não pelo modelo. Ao lado, o cabeçalho da rodada de 18/09/2026, em que cinco lentes revisaram a própria mesa.
A mesa não aplica código, não é portão de merge e não decide: a linha "Decisão do time" fica em branco, e o validador recusa o consolidado se o modelo a preencher.
Testes do projeto: VERDE
Citações conferidas no disco: 108 de 108 existem
Tokens: 914 mil
Orçamento: estimativa 1.36 M · teto 2.00 M
Decisões
Em vez de: As 28 lentes em toda rodada.
Custo aceito: Menos pontos de vista por pergunta; em troca, cerca de 0,9 M de tokens contra 8,45 M da mesa cheia.
Em vez de: Confiar nas citações que o modelo escreve.
Custo aceito: A conferência prova que a linha existe, não que sustenta a afirmação; o limite está escrito no protocolo.
Em vez de: Colar o conteúdo do projeto direto no prompt.
Custo aceito: Um envelope em cada porta de entrada e testes de injeção para cada uma.
Em vez de: Ler o backlog sem expectativa prévia.
Custo aceito: Um passo a mais. Em 22/09, a mesa refutou a hipótese do próprio autor.
Em vez de: Descobrir o custo de uma rodada depois de pagá-la.
Custo aceito: A estimativa é conservadora e pode recusar uma rodada que caberia; há uma ordem expressa para passar.
Como foi construído
- 11/09Os guias
Os especialistas mais seguidos, com curso ou canal; cada guia com citação, link e data.
- 12/09A mesa
Os 28 guias viram subagentes, a mesa 3D e o motor no Antigravity.
- 16/09A mesa revisa a si mesma
As 28 lentes custam 8,45 M de tokens e inventam 5 citações; 27 de 28 pedem uma bancada enxuta.
- 18/09As garantias
Bancada por tema, teto de 2 M, conferência de citações, validador do consolidado, máscara de segredos e aposta obrigatória.
- 22/09O teste de mutação
A primeira medição acha defeitos que a suíte verde não pegava; entram 6 testes novos.
- 11/10O roteador de temas
O laya-tema é avaliado uma única vez no conjunto trancado e passa a sugerir o tema da mesa.
Desenvolvi com agentes de IA de código. Cada falha da própria mesa fica registrada com data, uma linha cada, no arquivo de instruções do projeto.
Hoje e a seguir
Hoje
A mesa roda em qualquer projeto, pelo Claude Code, pelo Codex ou pelo Antigravity, e o Journal atualiza os guias toda sexta-feira. O mesmo motor já serve a mais duas mesas: a dos Designers 3D e a Banca do TCC.
A seguir
- Rodar o protocolo de eficácia pré-registrado: 10 defeitos semeados e 3 iscas, a mesa contra um revisor único.
- Conferir se a citação sustenta a afirmação, e não só se a linha existe.
Os guias sintetizam conteúdo público dos especialistas; nenhum deles endossou o projeto.
As imagens são quadros do comercial do projeto, desenhados para o vídeo a partir da mesa 3D.